 FR
 EN
Prédiction des défauts de prêt en banque de détail via MLOps
Un modèle de scoring du risque de défaut sur les prêts personnels, industrialisé de bout en bout : 288 runs tracés dans MLflow, optimisation Optuna sur un score composite pondéré par l'enjeu métier, conteneurisation Docker et déploiement continu sur AWS. Et la lecture honnête d'une exactitude de 99,6 %, quand une règle à une seule variable atteint déjà 97,9 % sur les mêmes données.
Voir sur GithubLe sujet
Les prêts personnels sont une source de revenus majeure des banques de détail, et leur talon d’Achille : chaque défaut non anticipé part en perte. Le jeu de données rassemble 10 000 dossiers clients dont 1 851 défauts (18,5 %) et sept variables, parmi lesquelles le nombre de lignes de crédit ouvertes, l’endettement total, le revenu, l’ancienneté et le score FICO. Deux questions en découlent. Quelle probabilité de défaut pour chaque client, et comment ce modèle finit par servir une décision de crédit plutôt que de rester dans un notebook.
Lire les données avant de sortir un modèle
Une seule variable, le nombre de lignes de crédit ouvertes, tranche l’essentiel du portefeuille. En dessous de deux lignes, aucun client ne fait défaut. À cinq lignes, 99,8 % font défaut. Une règle unique, défaut attendu au-delà de quatre lignes de crédit, se trompe déjà sur seulement 41 clients parmi les 1 953 réservés au test, soit 97,9 % d’exactitude sans le moindre modèle.
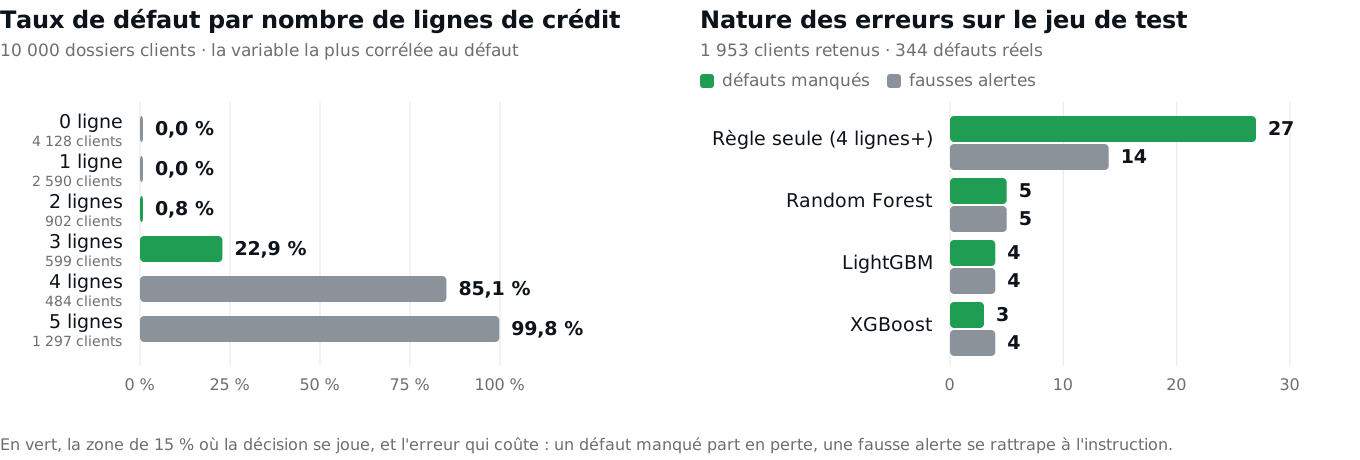
Cette référence recadre tout le projet. Les 15 % de clients qui détiennent deux ou trois lignes de crédit sont ceux dont la décision est réellement incertaine, et ils concentrent 27 des 41 erreurs de la règle. Dans cette zone, la séparation vient d’ailleurs : score FICO médian de 590 chez ceux qui font défaut contre 647 pour les autres, ratio dette/revenu de 0,21 contre 0,16, trois ans d’ancienneté contre cinq. C’est ce signal que le feature engineering doit capter, et la raison pour laquelle un chiffre d’exactitude ne constitue pas, à lui seul, un argument.
Le pipeline
- Nettoyage : un facteur IQR réglé variable par variable (2,80 sur le montant de prêt restant dû, 3,90 sur l’endettement total, 1,90 sur le revenu, 2,00 sur le score FICO), combiné à un filtre z-score à 3 sigma. 237 dossiers retirés, soit 2,4 % du jeu de données.
- Feature engineering : ratio dette/revenu, ratio crédit/revenu, écart à une référence FICO de 700 et score FICO normalisé, ajoutés aux variables brutes.
- Découpage : 60/20/20, soit 5 857 dossiers d’entraînement, 1 953 de validation et 1 953 de test. Le suréchantillonnage SMOTE suivi d’un sous-échantillonnage aléatoire ne s’applique qu’au jeu d’entraînement : validation et test conservent leur taux de défaut naturel pour que la performance mesurée reste représentative du portefeuille réel.
Ces facteurs IQR sont l’étape qui mérite d’être défendue. Appliqué au 1,5 standard, le même filtre retire 840 dossiers et emporte 658 défauts avec eux, soit un tiers de la classe minoritaire perdu avant même l’entraînement.
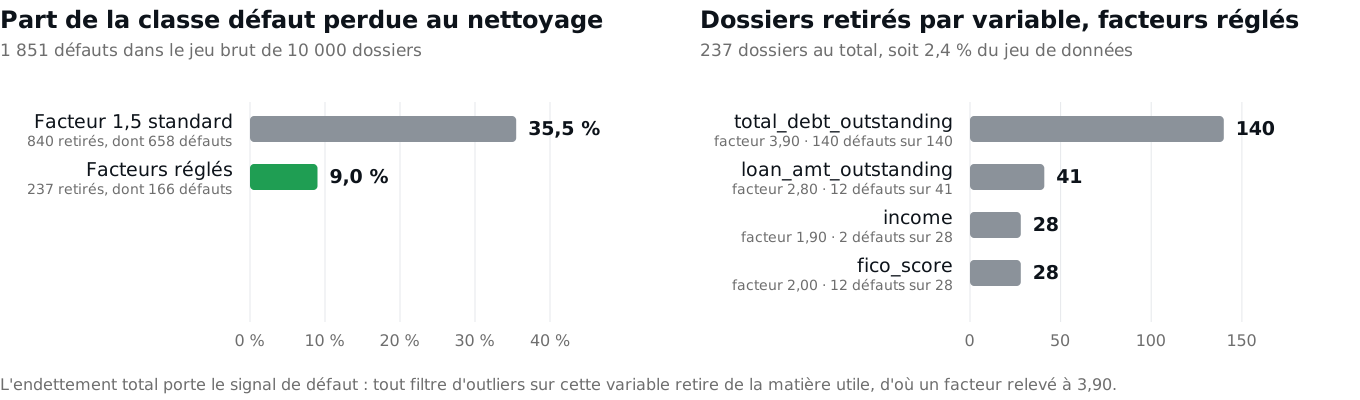
La raison est structurelle. Un endettement total élevé n’est pas du bruit ici, c’est le signal de défaut : tout seuil sur cette variable entame précisément la population que le modèle doit attraper. Relever son facteur à 3,90 ramène la perte à 9 % des défauts, et même là, les 140 dossiers encore retirés sont des défauts, tous sans exception. Une règle d’outliers traitée comme une étape d’hygiène aurait biaisé le jeu d’entraînement en silence.
Optimisation et traçabilité
Optuna optimise chaque famille de modèles sur un objectif unique, un score composite pondérant 0,4 AUC-ROC, 0,3 Precision-Recall AUC, 0,2 F1, 0,05 rappel et 0,05 précision. Écrire l’arbitrage sous forme d’un seul nombre oriente la recherche d’abord vers la qualité du classement, ensuite vers le comportement au seuil, au lieu de laisser l’exactitude récompenser un modèle qui joue la classe majoritaire.
288 runs répartis sur quatre expériences MLflow (régression logistique, random forest, XGBoost, LightGBM) enregistrent leurs paramètres, métriques, matrice de confusion, signature de modèle et un tag de version, chacun rattaché au commit qui l’a produit. Chaque résultat de cette page remonte au run qui l’a généré.
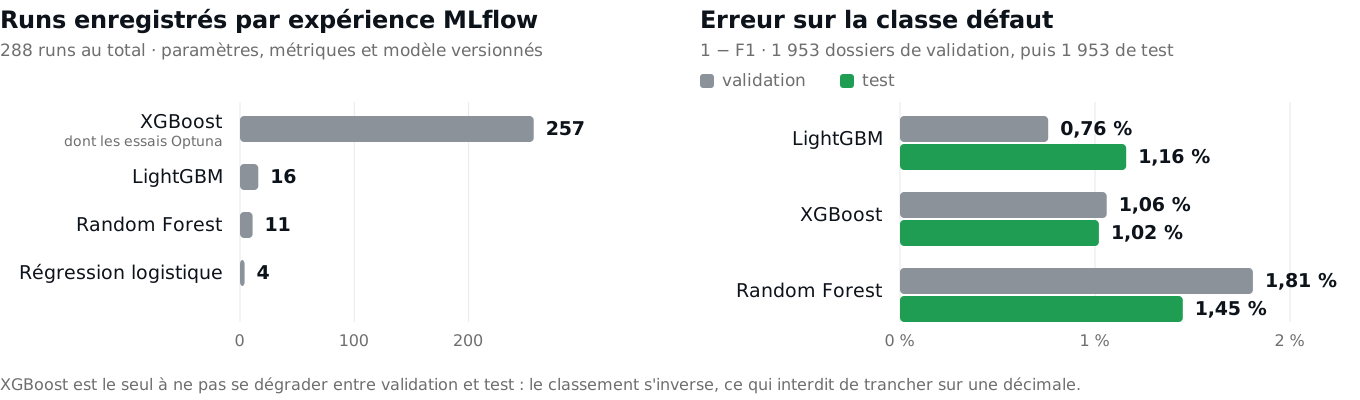
Ce registre tranche aussi le choix du modèle. LightGBM domine en validation et perd sur le test, XGBoost est la seule famille qui ne se dégrade pas entre les deux. Trancher sur la seule décimale de validation aurait mis le mauvais modèle en production.
Résultats
Sur le jeu de test de 1 953 dossiers, dont 344 défauts réels :
- XGBoost : 99,64 % d’exactitude, 7 erreurs (4 faux positifs, 3 défauts manqués), 99,1 % de rappel sur la classe défaut.
- LightGBM : 99,59 %, 8 erreurs.
- Random Forest : 99,49 %, 10 erreurs.
- Régression logistique, conservée comme référence lisible : 98,3 % d’exactitude et 0,949 de F1 en validation, avec une AUC-ROC de 0,999 qui en dit plus sur les données que sur le modèle.
Rapporté à la règle de référence, le modèle optimisé supprime 34 de ses 41 erreurs, et le gain tombe là où ça coûte : 27 défauts passent au travers de la règle contre 3 au travers d’XGBoost. Les fausses alertes descendent de 14 à 4, mais c’était l’erreur bon marché, celle que l’instruction du dossier rattrape avant tout décaissement. C’est cette asymétrie qui se présente à une équipe risque, pas la troisième décimale d’un score d’exactitude.
Du modèle au produit
L’application Streamlit sert de console sur tout le cycle de vie plutôt que de démonstrateur de prédiction : analyse exploratoire, feature engineering, lancement d’un run tracé avec choix du modèle, du sous-ensemble de variables et du budget d’essais, exploration du registre d’artefacts MLflow, et scoring d’un client contre le modèle de production.
Le packaging suit : dépendances verrouillées par Poetry, image Python 3.12 slim avec health check Streamlit, et un pipeline GitHub Actions qui formate, lint et vérifie la santé du conteneur à chaque pull request avant de pousser une image datée vers Docker Hub et vers Amazon ECR pour déploiement sur ECS en eu-west-3.
Ce que le projet démontre
Une discipline d’évaluation avant la sophistication algorithmique : une référence qui qualifie la difficulté réelle avant d’entraîner quoi que ce soit, une métrique de succès écrite comme un arbitrage métier plutôt que comme un taux d’exactitude, et un historique de runs qui rend chaque choix défendable après coup. Ces réflexes se transposent directement aux systèmes LLM, où le point de référence, la règle de scoring et la traçabilité de chaque run comptent davantage que le modèle posé au dessus.