 FR
 EN
Quantum Insights, pipeline RAG sur les publications ArXiv
Assistant de recherche RAG qui rend la littérature scientifique en physique quantique accessible à tous les niveaux : recherche sur ArXiv, synthèse et vulgarisation par LLM, extraction de code, avec un niveau d'explication ajustable du débutant à l'expert. Pipeline complet, des embeddings à la génération, déployé sur AWS.
mriusero/gen-ai-quantum-insightQuantum Insights is an AI-driven tool designed to make quantum physics research accessible to everyone. It offers easy-to-understand summaries, concept explanations, and code insights from quantum publications, bridging the gap between advanced research and the wider community.Le sujet
La recherche en physique quantique avance vite et reste hermétique : jargon, formalisme mathématique, volume de publications. Quantum Insights réduit cette barrière en transformant les papiers ArXiv en explications adaptées au niveau du lecteur, du novice au chercheur.
Fonctionnalités
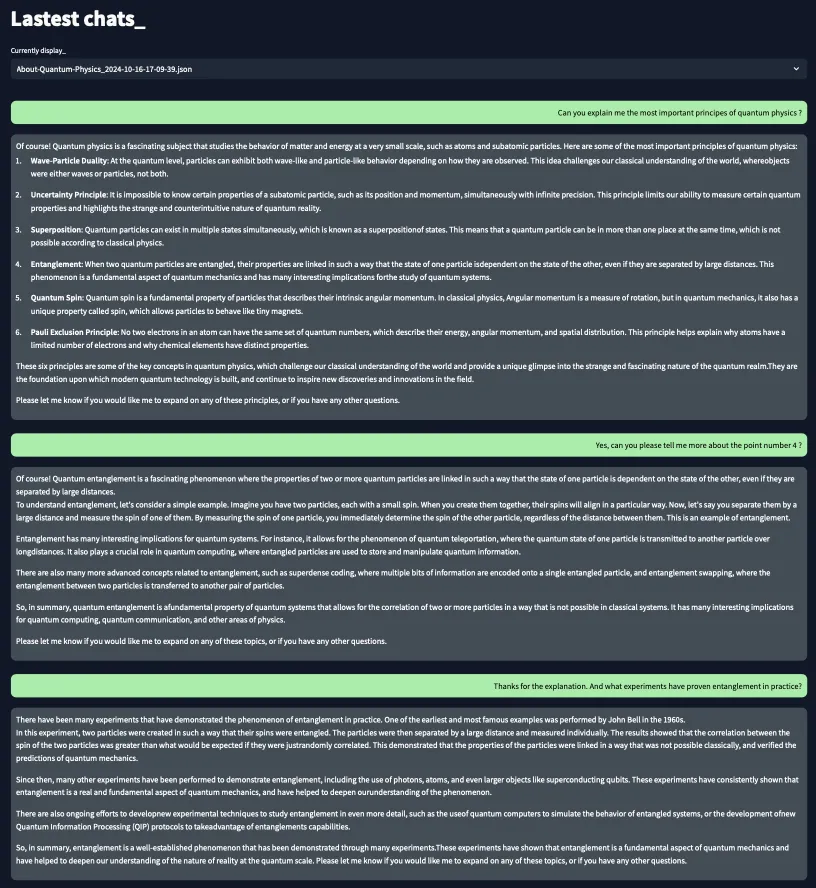
- Synthèses de recherche : recherche et extraction des informations clés des articles ArXiv les plus récents.
- Explication de concepts : décomposition des sujets complexes en notions simples et progressives.
- Explication de code : des extraits de code illustrant les concepts, identifiés et expliqués en contexte.
- Niveau ajustable : la même source scientifique expliquée pour un public débutant, intermédiaire, avancé ou expert.
L’architecture RAG
Un pipeline de génération augmentée par récupération assemblé de bout en bout, indexant 300 articles ArXiv en environ 8 700 chunks vectoriels.
- Ingestion : synchronisation incrémentale de l’API ArXiv vers SQLite, insertion ou mise à jour selon la révision, de sorte qu’un nouveau passage ne vectorise que ce qui a réellement changé. 225 PDF chargés par lots en parallèle.
- Découpage : orienté structure plutôt que taille fixe. SpaCy segmente les phrases, les paragraphes sont assemblés jusqu’à 512 tokens mesurés avec le tokenizer du modèle, avec 206 tokens de recouvrement pour que les équations restent attachées au texte qui les explique.
- Indexation : embeddings avec sentence-transformers (all-MiniLM-L6-v2), stockage vectoriel persistant dans ChromaDB.
- Récupération et génération : les 5 meilleurs passages sont récupérés dans ChromaDB, puis LLaMA 2 (7B chat) génère la réponse au niveau demandé via l’endpoint Hugging Face Inference.
- Matériel : ingestion, embeddings et récupération tournent intégralement sur CPU, sans GPU nulle part dans le pipeline. Seule la génération 7B est déportée sur un endpoint distant.
- Budget de contexte : la fenêtre de 4 096 tokens est la contrainte dominante. Prompt et historique sont comptés avec le tokenizer LLaMA 2, affichés en direct dans l’interface, et l’historique de conversation est tronqué pour que la réponse tienne dans la fenêtre.
- Industrialisation : interface Streamlit, image Docker, pipeline GitHub Actions (lint, health check, build d’image) et déploiement sur AWS ECS.
La contrainte de 2024
Construit sur LLaMA 2 7B chat, appelé via un endpoint de text-generation brut : pas de template de chat, pas de tool calling, pas de sortie structurée. En pratique, le modèle se comportait davantage comme un moteur de complétion que comme les LLM instruits d’aujourd’hui. Tout ce que les frameworks actuels fournissent clé en main a dû être écrit à la main : découpage, embeddings et persistance, récupération, assemblage du prompt, mémoire conversationnelle, et une boucle de génération qui réinterroge le modèle jusqu’à stabilisation de la réponse, pour compenser les sorties tronquées.
Limites
Pas d’étape de reranking, pas d’évaluation automatisée de la qualité des réponses, un seul modèle de génération. Sur un 7B open-source de 2024, le budget de contexte était la contrainte dominante sur chaque réponse. Un harnais d’évaluation systématique est ce que j’ajouterais en premier aujourd’hui.
Aperçus

Ce que le projet démontre
Toute la pile RAG construite à la main, avant que les frameworks n’en fassent un standard : chunking orienté structure, récupération, mémoire conversationnelle et gestion du budget de tokens écrits de zéro sous une fenêtre de 4 096 tokens. Maîtriser ces rouages est exactement ce qu’il faut aujourd’hui pour déboguer la qualité du retrieval, contenir les coûts de contexte et concevoir le harnais d’évaluation qui manque encore à ce pipeline.