 FR
 EN
Total Productive Maintenance sur des robots industriels
Prédiction de durée de vie résiduelle pour une flotte de 50 robots affectés au remplacement de combustible nucléaire : filtrage particulaire sur des mesures de fissure bruitées, analyse de survie avec un modèle Gradient Boosting optimisé sur l'indice de concordance, un LSTM multi-tâches de prévision, et un cadrage économique des remplacements sous contrainte de flotte.
mriusero/predictive-maintenance-on-industrial-robotsThis project develops predictive maintenance models for industrial robots in nuclear fuel replacement, leveraging data analytics, machine learning, and decision-making frameworks to optimize robot fleet management and extend operational uptime. Key phases include data exploration, feature engineering, RUL prediction, and maintenance decision-makingLe sujet
Dans un environnement aussi critique que le remplacement de combustible nucléaire, l’indisponibilité d’un robot n’est pas une option. Le cahier des charges : à partir des historiques de dégradation d’une flotte de 50 robots, prédire lesquels survivront aux six prochains mois et décider quand les remplacer. Le modèle de coûts encode l’économie réelle de la maintenance : une défaillance manquée coûte deux fois ce que rapporte une prédiction juste, et remplacer un robot trop tôt est pénalisé au prorata de la durée de vie sacrifiée. Ni trop tard, ni trop tôt.
Extraire le signal d’une physique bruitée
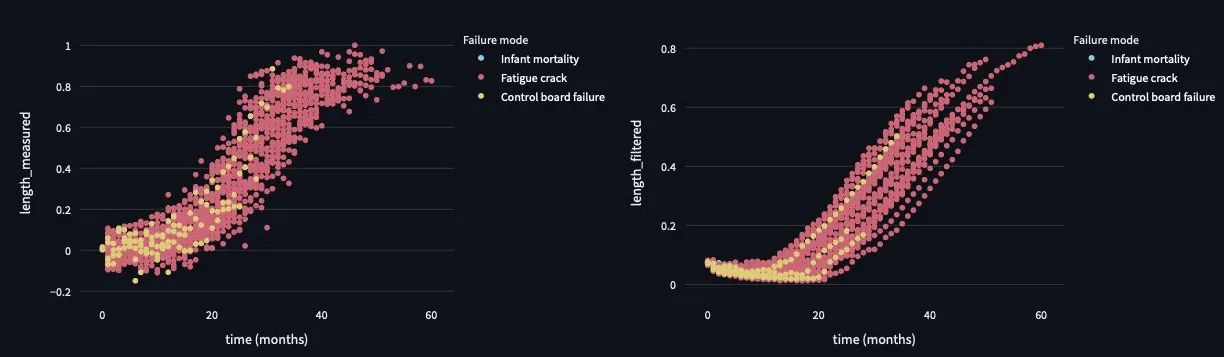
Chaque robot peut mourir de trois façons : mortalité infantile liée aux défauts de fabrication, pannes aléatoires de carte de contrôle, et fissuration par fatigue mesurée chaque mois. La croissance de fissure suit une loi logistique dont les paramètres matériaux dérivent dans le temps, observée à travers des mesures bruitées, ce qui rend les séries brutes inexploitables telles quelles.
- La dégradation est modélisée comme un système à espace d’états : croissance logistique latente avec bruit de processus sur ses trois paramètres, plus bruit d’observation sur la mesure.
- Un filtre particulaire à 1 000 particules estime, robot par robot, la longueur de fissure latente et les trois coefficients de dégradation au fil du temps.
- Les séries filtrées et les coefficients estimés alimentent ensuite les modèles comme features, aux côtés de statistiques statiques et glissantes, de variables de décalage et de ratio, et d’une décomposition tendance, saisonnalité et résidu de chaque série.
- Le jeu de features est passé au crible d’une analyse de corrélation et des facteurs d’inflation de variance pour maîtriser la multicolinéarité ; l’importance des variables confirme ensuite que les features construites pèsent plus que la mesure brute.
Trois modèles, un verdict
- Classifieur Random Forest : écarté. Il attribue un mode de défaillance à chaque robot mais ne sait pas dire si une panne surviendra réellement dans la fenêtre.
- LSTM bidirectionnel multi-tâches, trois couches récurrentes empilées avec une branche de régression et une branche de classification : il prévoit six mois de croissance de fissure et classifie le mode de défaillance. Par construction, il ne capte que les pannes liées à la longueur de fissure, pas les pannes aléatoires précoces.
- Modèle de survie Gradient Boosting (scikit-survival), hyperparamètres recherchés avec Optuna en maximisant l’indice de concordance censuré : le modèle retenu. Il prédit la probabilité de défaillance à six mois par robot : 96 % d’accuracy, ROC-AUC de 0,99, et 25 mois de panne manqués contre 695 correctement écartés.
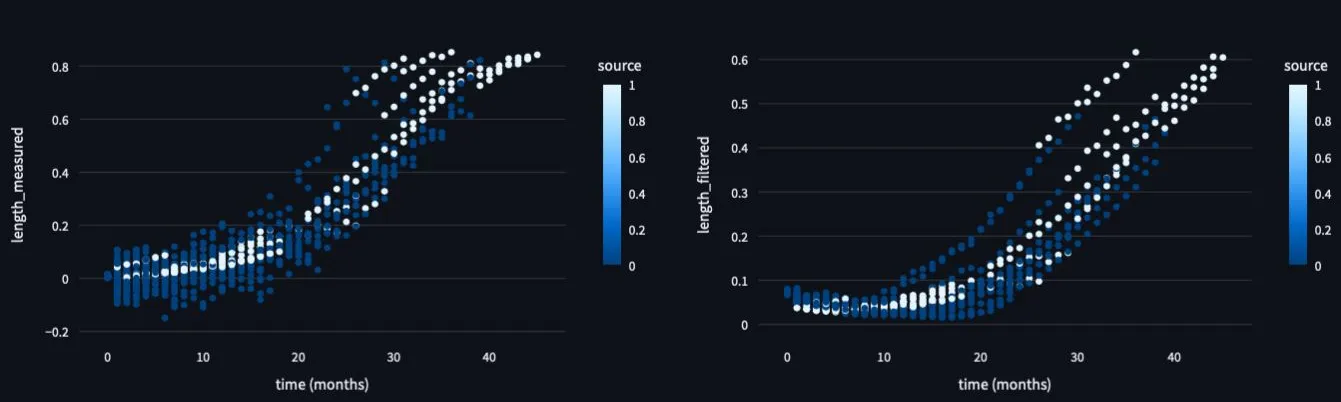
Testé sur des séquences tronquées, le LSTM prolonge chaque trajectoire de dégradation mois par mois, sur les séries mesurées comme filtrées : c’est cette extension que le cadre de décision exploite lorsqu’aucune défaillance n’est prédite dans la fenêtre.
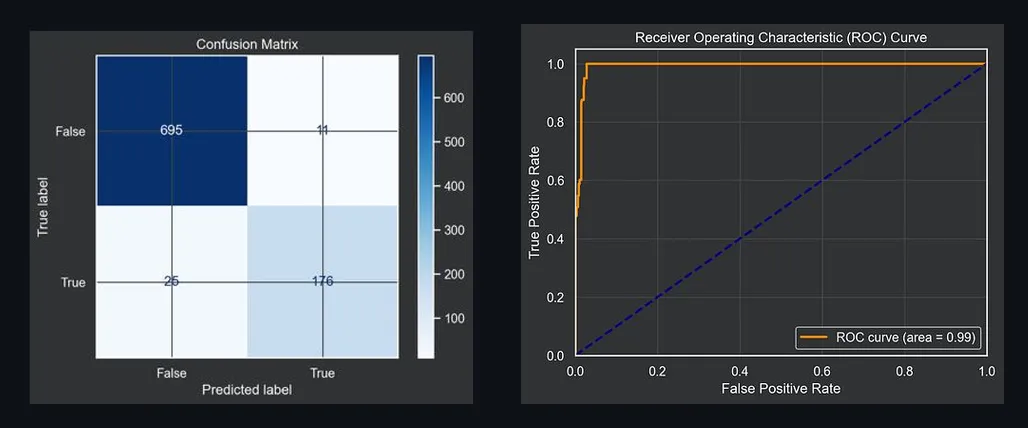
Un AUC de 0,99 se diagnostique plutôt qu’il ne se célèbre : sur données terrain, un score aussi propre signale presque toujours une fuite. Ici, il s’explique en grande partie par le benchmark lui-même, une dégradation simulée depuis une loi logistique connue et un pseudo jeu de test issu du même processus génératif que les données d’entraînement. La conclusion honnête : le modèle a capturé la physique du benchmark, et transposer ce score à une flotte réelle exigerait d’abord une validation plus stricte, avec des splits par robot et des fenêtres temporelles tenues à l’écart.
De la prédiction à la décision
Prédire n’est que la moitié du problème. Le cadre de décision traduit les probabilités de survie en arbitrage des remplacements avant mission sous contrainte de flotte : chaque mission exige au moins dix robots opérationnels, échoue si trois ou plus tombent en panne, et chaque remplacement préventif est facturé à une fraction de la durée de vie résiduelle sacrifiée. Le modèle de survie fournit le risque de défaillance, le LSTM prolonge les trajectoires de dégradation, et la structure de coûts tranche.
Le packaging
L’ensemble du pipeline s’exécute depuis une application Streamlit dockerisée : exploration des données, filtrage particulaire, entraînement avec recherche d’hyperparamètres optionnelle, et prédiction. La validation s’appuie sur un pseudo jeu de test généré par troncature aléatoire des séquences de dégradation complètes, reproduisant hors ligne les conditions que le modèle rencontrerait en exploitation : prédire à partir d’historiques de dégradation en cours.
Ce que le projet démontre
Le pont entre ma culture industrielle (TPM, fiabilité, gestion de flotte) et la modélisation : estimation d’état sur une physique bruitée, analyse de survie menée jusqu’à la décision économique, et des métriques lues avec un regard critique plutôt que prises pour argent comptant. Ce dernier réflexe, traiter un AUC de 0,99 comme un symptôme à investiguer avant d’être un résultat à annoncer, est exactement la discipline qu’exige l’évaluation des systèmes d’IA en production.