 FR
 EN
Classification de panneaux de signalisation
Quatre architectures de deep learning comparées sur les 43 classes du benchmark GTSRB, puis mises à l'épreuve sous bruit, flou de mouvement et occlusion : 99,4 % d'accuracy après optimisation Optuna, et 99,5 % en conditions dégradées après réentraînement adversarial. Interprétabilité Grad-CAM à l'appui. Le socle vision par ordinateur des systèmes ADAS.
mriusero/road-sign-classificationA deep learning project focused on classifying road signs using the GTSRB dataset. This repository includes data augmentation, model optimization, and regularization techniques, featuring both CNN and ResNet-inspired architectures tested under diverse conditions.Le sujet
Reconnaître un panneau est facile en laboratoire et difficile sur la route : pluie, flou de mouvement, panneau à moitié masqué par un camion. Pour une brique ADAS, la vraie question n’est pas l’accuracy sur un jeu de test propre, mais la performance qui subsiste quand les conditions se dégradent. Le projet compare quatre architectures sur le benchmark GTSRB, puis mesure ce que chacune perd en conditions réelles.
Les données
- GTSRB, le benchmark allemand de référence : 12 630 images, 43 classes de panneaux, métadonnées de forme, couleur et pictogramme.
- Redimensionnement en 64 × 64 RGB, normalisation, encodage one-hot et découpage 70/15/15 (8 841 / 1 894 / 1 895 images).
- Augmentation ×5 du jeu d’entraînement par rotation, symétrie, zoom et recadrage, soit 44 205 images pour forcer la généralisation.
Les architectures comparées
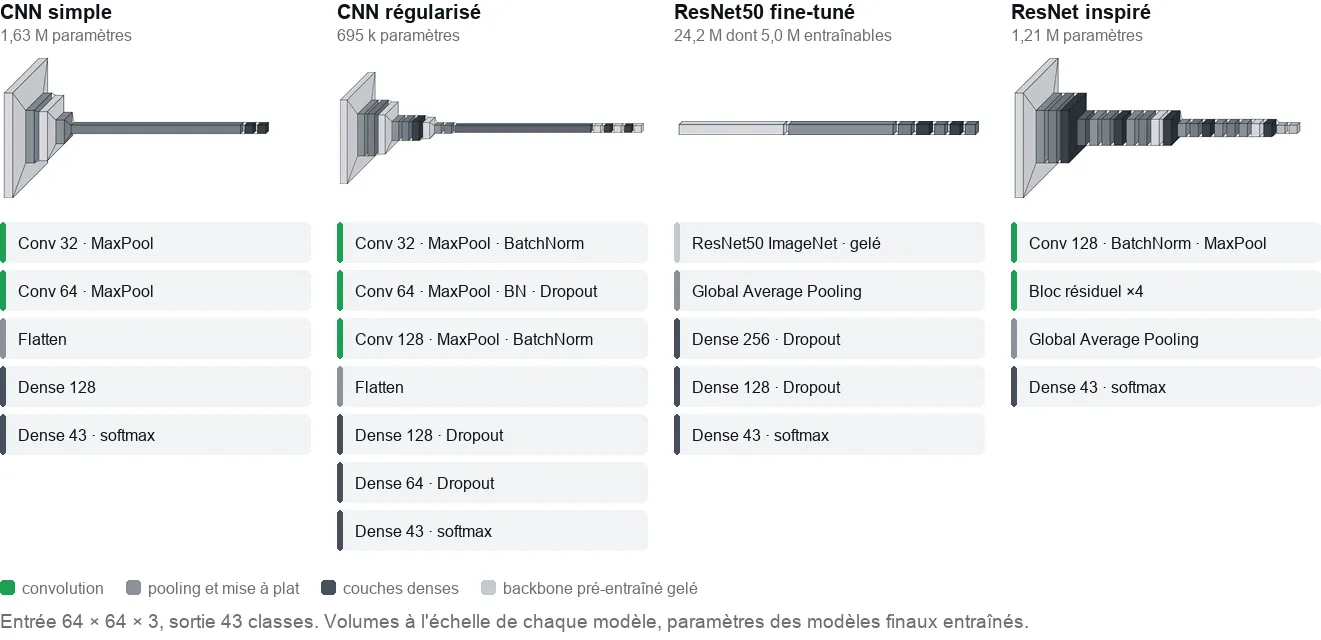
Quatre modèles entraînés dans le même protocole, jugés sur le F1-score par classe, l’AUC-ROC et la précision moyenne :
- CNN simple : F1 de 93,9 % (AUC-ROC 0,9988). La référence basse.
- CNN régularisé (Dropout, Batch Normalization) : F1 de 98,6 % (AUC-ROC 0,9999). Le meilleur rapport performance / coût de calcul, avec 695 k paramètres contre 24,2 M pour ResNet50.
- ResNet50 fine-tuné : F1 de 84,2 %. Le transfer learning depuis ImageNet décroche ici : en entrée 64 × 64, ResNet50 réduit l’image à une carte de 2 × 2 avant classification et perd le détail du pictogramme.
- ResNet inspiré, quatre blocs résiduels entraînés de zéro : F1 de 94,6 % (AUC-ROC 0,9996).
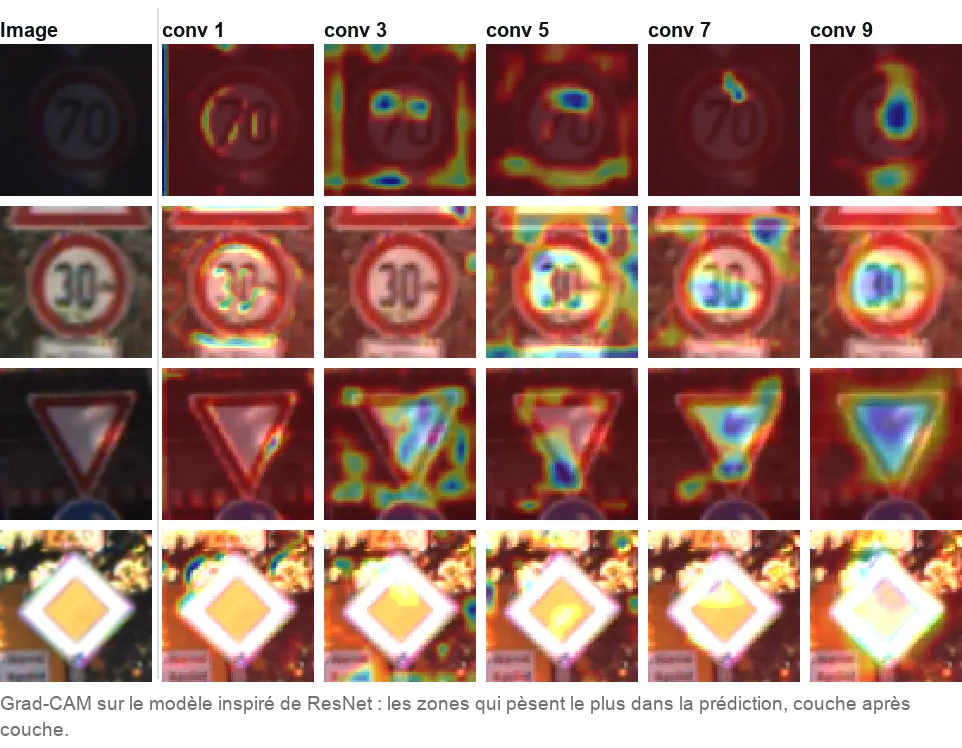
Les deux meilleurs candidats passent ensuite par une optimisation Optuna de 100 essais (taux d’apprentissage, taille de batch, taux de dropout, profondeur résiduelle) avec early stopping : le ResNet inspiré atteint 99,4 % d’accuracy et le CNN régularisé 98,2 %. Le Grad-CAM et les activations couche par couche confirment que la décision se concentre sur le pictogramme et ses contours plutôt que sur l’arrière-plan, et localisent les erreurs résiduelles : les limitations de vitesse pour le CNN régularisé, les panneaux de danger graphiquement proches pour le ResNet inspiré.
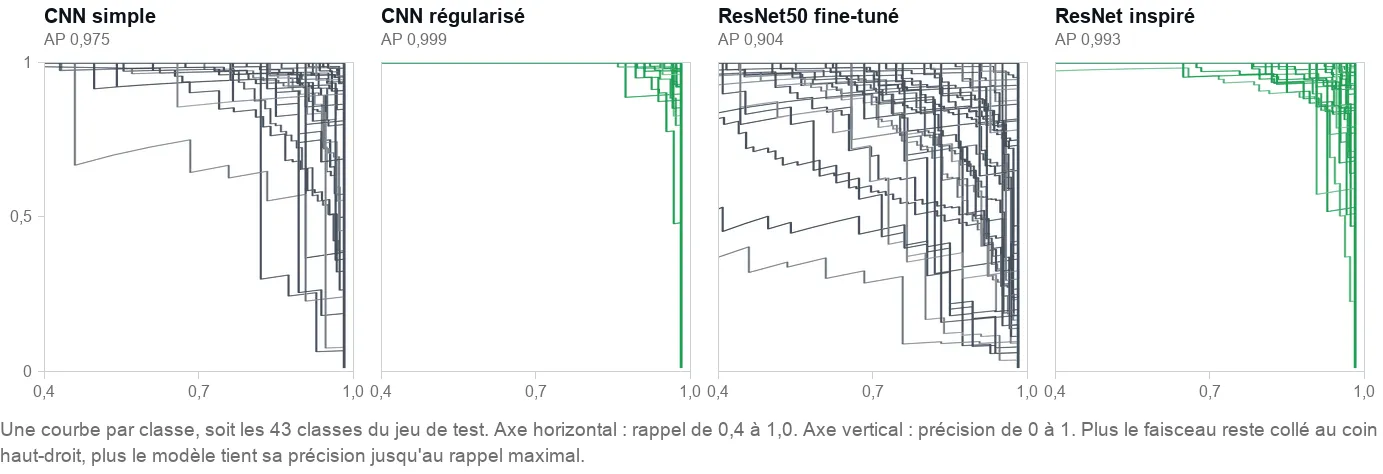
La moyenne masque toutefois la dispersion : lue classe par classe, la courbe précision-rappel sépare nettement un modèle qui tient ses 43 classes d’un modèle qui n’en tient que la majorité.
La robustesse en conditions dégradées
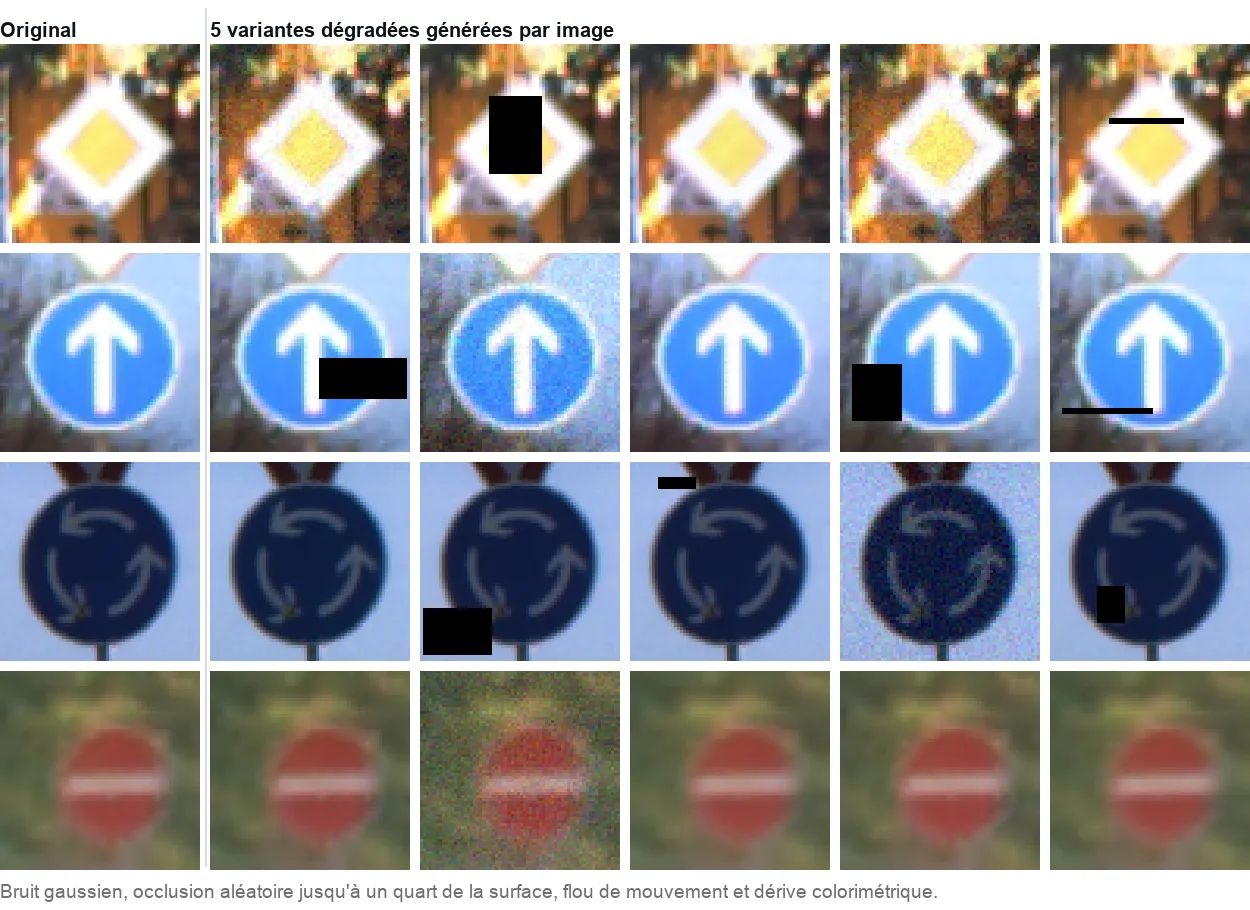
Le jeu de test est rejoué en version dégradée : bruit gaussien, flou de mouvement, dérive colorimétrique et occlusion aléatoire pouvant masquer jusqu’à un quart de la surface du panneau, soit 9 475 images perturbées.
- Sans adaptation, la performance décroche : 94,4 % d’accuracy pour le ResNet inspiré, 92,2 % pour le CNN régularisé.
- Réentraînés sur les données adversariales, ils remontent à 99,5 % et 98,7 %, avec une précision moyenne de 0,999.
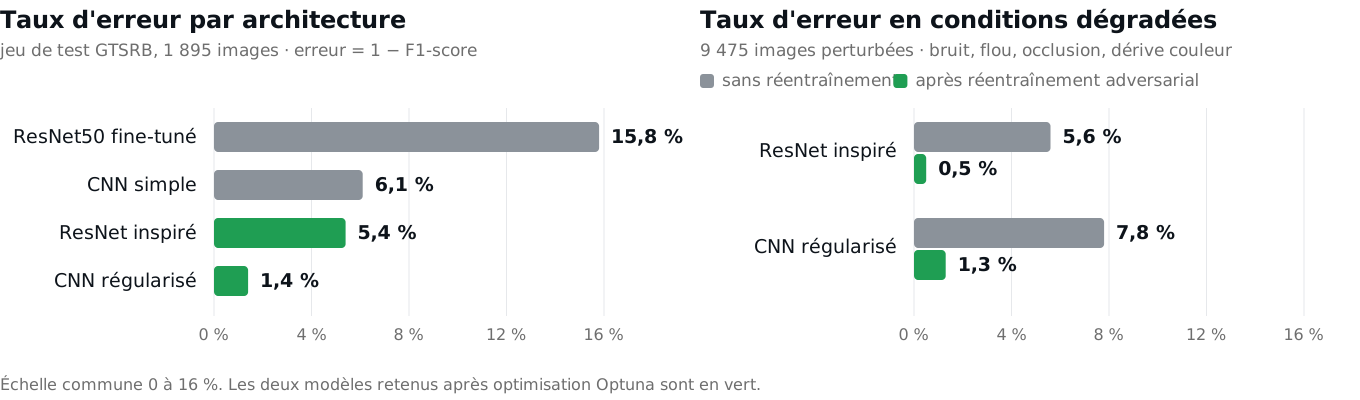
L’écart de dégradation départage les deux finalistes : le ResNet inspiré encaisse mieux le bruit, quand le CNN régularisé reste le bon choix pour une cible embarquée contrainte en calcul.
Ce que le projet démontre
Un protocole d’évaluation qui va au-delà de l’accuracy de laboratoire : métriques par classe, tests adversariaux calibrés sur les conditions terrain, interprétabilité pour vérifier ce que le modèle regarde vraiment, et un choix d’architecture argumenté par les chiffres plutôt que par la complexité du réseau. La qualité de l’entraînement pèse davantage sur la performance finale que la profondeur du modèle. Les mêmes réflexes, des jeux de stress construits sur les vrais modes de défaillance et des métriques qui localisent les faiblesses au lieu de les moyenner, sont ceux qu’exige aujourd’hui l’évaluation des systèmes LLM en production.
Télécharger la présentation du projet (PDF, 10 pages, en anglais)